Elegir un modelo
Qué modelo cabe en tu tarjeta gráfica.
Los modelos de embedding también aparecen en la lista. Convierten texto en vectores para la biblioteca y no pueden sostener una conversación.
Explorar y descargar#
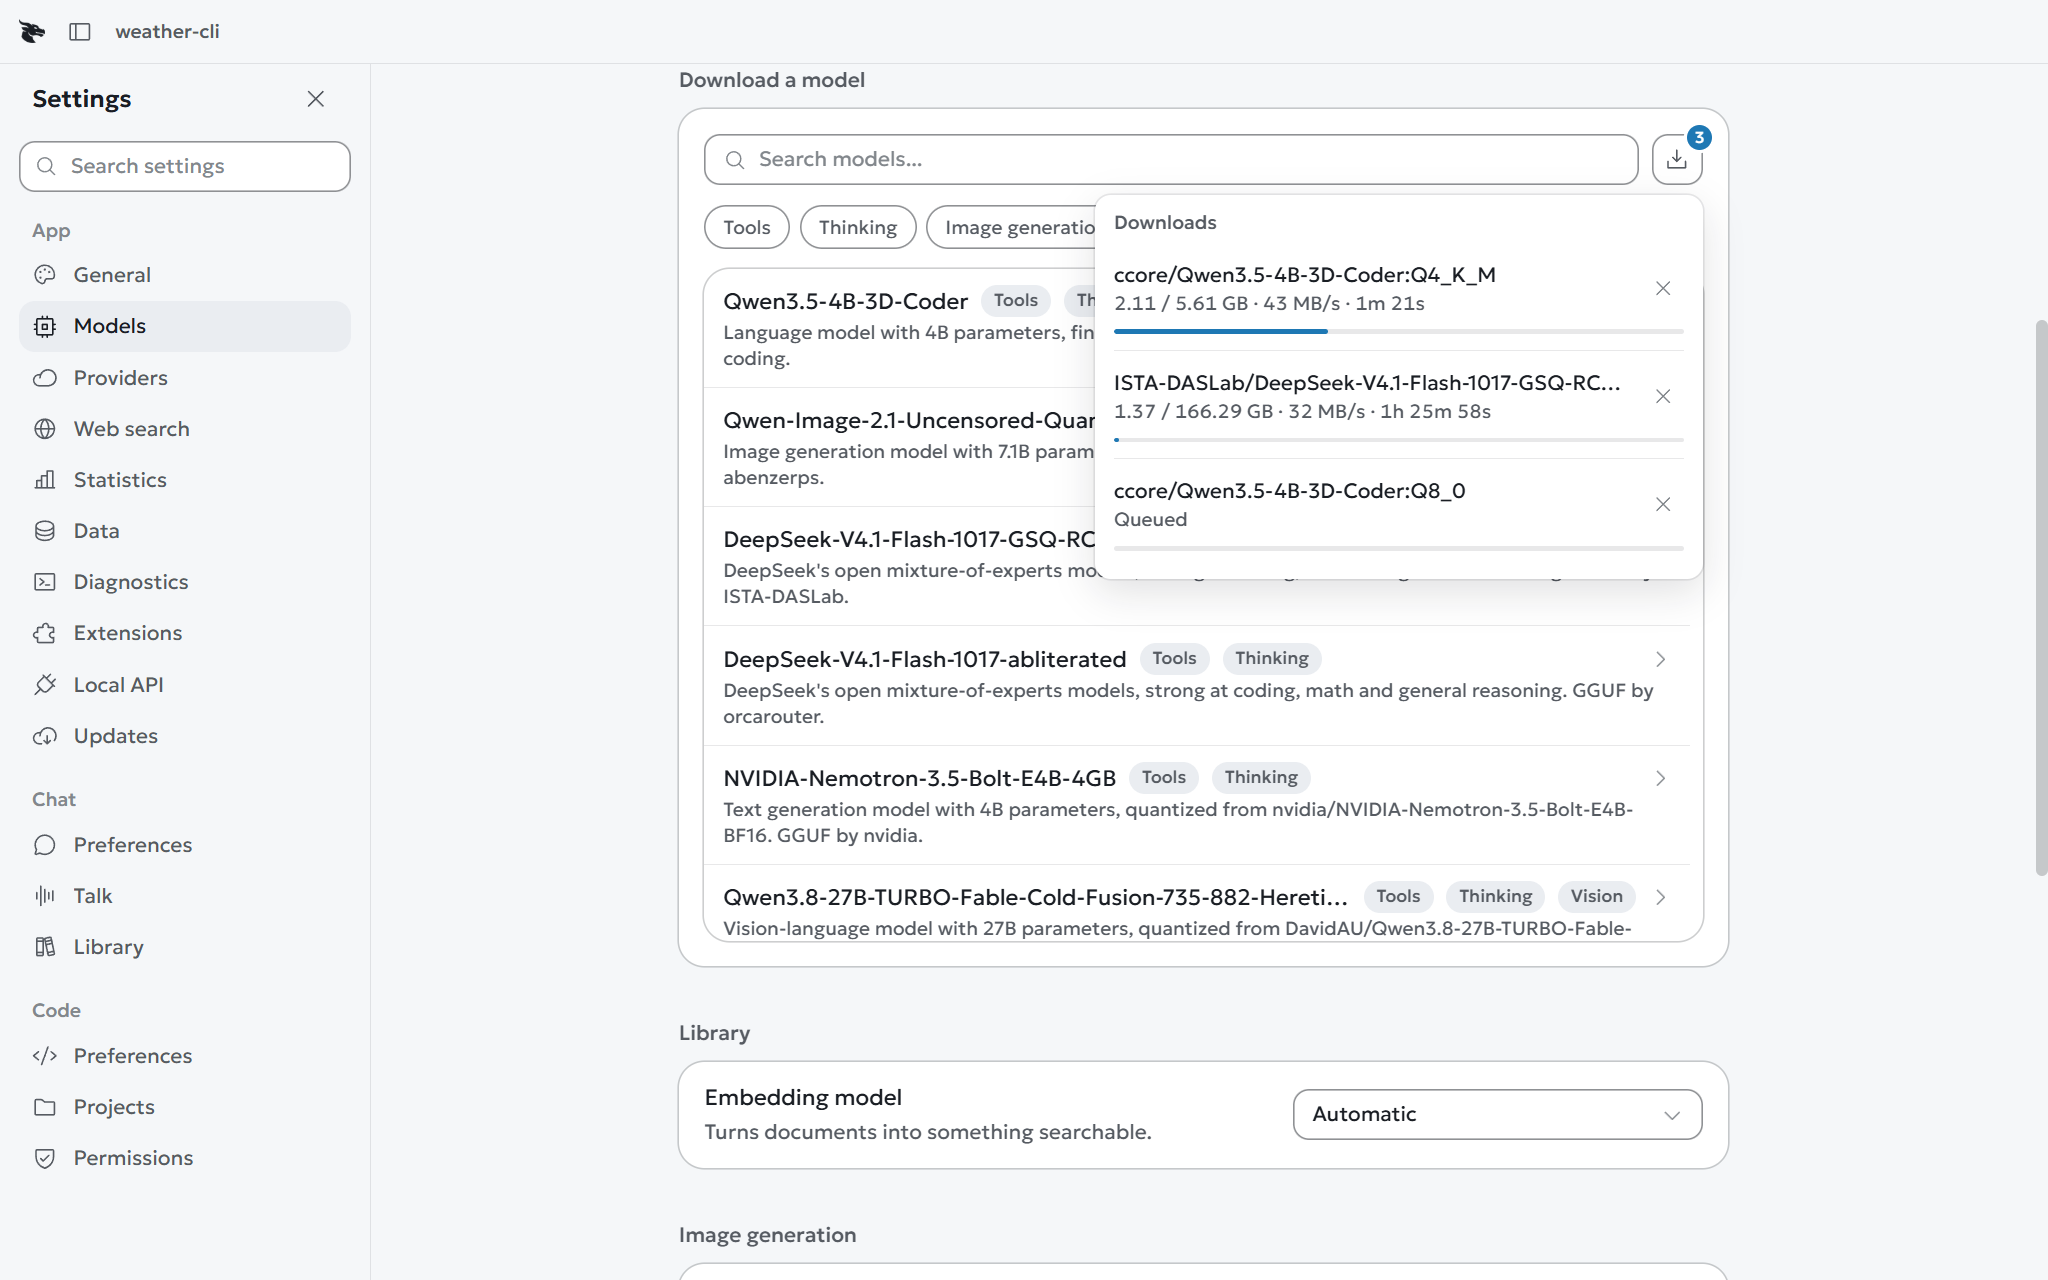
Ajustes → Modelos muestra los 100 modelos GGUF más populares de Hugging Face, con búsqueda. Haz clic en un modelo para desplegar sus variantes de cuantización. Cada una muestra el tamaño de su archivo.
Haz clic en el botón de descarga de una variante. Se descargan dos a la vez y el resto espera en una cola, así que puedes preparar todas las que quieras. El icono de descarga a la derecha de la barra de búsqueda muestra con un distintivo rojo cuántas están en camino. Haz clic en él para ver cada una con su progreso, el tiempo restante y un botón de cancelar. Cancelar una descarga en curso elimina al instante el archivo .download parcial, y cancelar una que está en cola la saca de la fila.
Cada modelo instalado lleva etiquetas: Chat, Code, Embedding o Images. Los modelos de embedding y de imágenes nunca se ofrecen como modelo de chat. Un modelo que la app aún no puede ejecutar, como el reconocimiento de voz o la síntesis de voz, no aparece en la lista de descargas.
Carga en memoria#
Draggy carga un modelo solo cuando envías una petición. Mientras el motor arranca, la línea de estado muestra el progreso: copia del modelo a la memoria RAM o de vídeo, lectura del modelo desde el disco, lectura de la petición y preparación del motor.
Windows y Linux#
Draggy elige el mejor escalón que cabe. Un modelo denso tiene que caber en la memoria de vídeo, y nunca más del 80 % de la memoria del sistema, porque el motor carga primero todo el modelo en RAM. Un equipo con menos de 2 GB de memoria de vídeo, como uno con gráficos integrados, se trata como si tuviera la mitad de su memoria del sistema, hasta 8 GB.
| Memoria de vídeo | Modelo denso |
|---|---|
| Desde 1 GB | Qwen 3.5 0.8B |
| Desde 2 GB | Qwen 3.5 2B |
| Desde 3,5 GB | Qwen 3.5 4B |
| Desde 6 GB | Gemma 4 E4B |
| Desde 7,5 GB | Qwen 3.5 9B |
| Desde 9,5 GB | Gemma 4 12B |
| Desde 11 GB | Ministral 3 14B |
| Desde 15,5 GB | Qwen 3.8 27B, Q3 |
| Desde 20 GB | Qwen 3.8 27B |
| Desde 23 GB | Qwen 3.8 27B, Q5 |
| Desde 32 GB | Qwen 3.8 27B, Q8 |
Un modelo de mezcla de expertos (MoE) mantiene su parte activa en la tarjeta y el resto en RAM, así que cuenta la memoria de vídeo y la RAM juntas: el 90 % de la primera más el 80 % de la segunda tiene que alojar el archivo.
| Memoria necesaria | Modelo MoE |
|---|---|
| 14 GB | GPT-OSS 20B |
| 19 GB | Gemma 4 26B |
| 25 GB | Qwen 3.6 35B |
| 40 GB | Qwen 3.6 35B, Q8 |
| 61 GB | Qwen 3.5 122B, Q3 |
| 82 GB | Qwen 3.5 122B |
| 94 GB | Qwen 3.8 Flash-Next, Q3 |
| 116 GB | Qwen 3.8 Flash-Next |
| 135 GB | DeepSeek V4 Flash, Q3 |
| 162 GB | DeepSeek V4 Flash |
| 210 GB | GLM-5.3-Flash |
| 250 GB | GLM-5.3-Flash, Q5 |
Los modelos más grandes piden además una tarjeta de 8 GB o más (10 GB desde DeepSeek V4 Flash, 12 GB para GLM-5.3-Flash).
Apple silicon#
Un Mac no tiene memoria de vídeo separada, así que Draggy usa el 75 % de su memoria unificada y deja el resto al sistema. Un chip base o Pro toma el modelo de la primera columna. Un Max o un Ultra, con mucho más ancho de banda de memoria, toma el tamaño siguiente cuando toda su memoria puede alojarlo.
| Memoria unificada | Base o Pro | Max o Ultra |
|---|---|---|
| Desde 8 GB | Gemma 4 E4B | Qwen 3.5 9B |
| Desde 16 GB | Ministral 3 14B | GPT-OSS 20B |
| Desde 24 GB | Qwen 3.8 27B, Q3 | Qwen 3.8 27B, Q3 |
| Desde 32 GB | Qwen 3.8 27B, Q5 | Qwen 3.8 27B, Q5 |
| Desde 48 GB | Qwen 3.8 27B, Q8 | Qwen 3.8 27B, Q8 |
| Desde 96 GB | Qwen 3.8 27B, Q8 | Qwen 3.8 Flash-Next, Q3 |
| Desde 128 GB | Qwen 3.8 Flash-Next, Q3 | Qwen 3.8 Flash-Next |
| Desde 192 GB | DeepSeek V4 Flash, Q3 | DeepSeek V4 Flash |
Un Mac con procesador Intel no es Apple silicon. Draggy dimensiona sus modelos con las reglas de la sección Windows y Linux de arriba.
Leer la cifra de la GPU#
Ajustes → Modelos muestra, en porcentaje, qué parte de cada modelo cabe en la GPU. Verde significa que cabe el 98 % o más del modelo. Ámbar, del 60 % al 98 %, funciona con una parte del modelo en la CPU, y es más lento. Rojo, por debajo del 60 %, es un tamaño demasiado grande: baja un tamaño.
Un modelo cargado tiene allí un botón Descargar, que libera la memoria de vídeo sin borrar nada.
El modelo de voz#
El modo de voz usa su propio modelo, configurado en Ajustes → Chat → [Hablar](doc:glossary#talk).