选择模型
哪个模型适合你的显卡。
嵌入模型也会列出。它们把文本转成向量,供文档库使用,但不能进行对话。
浏览与下载#
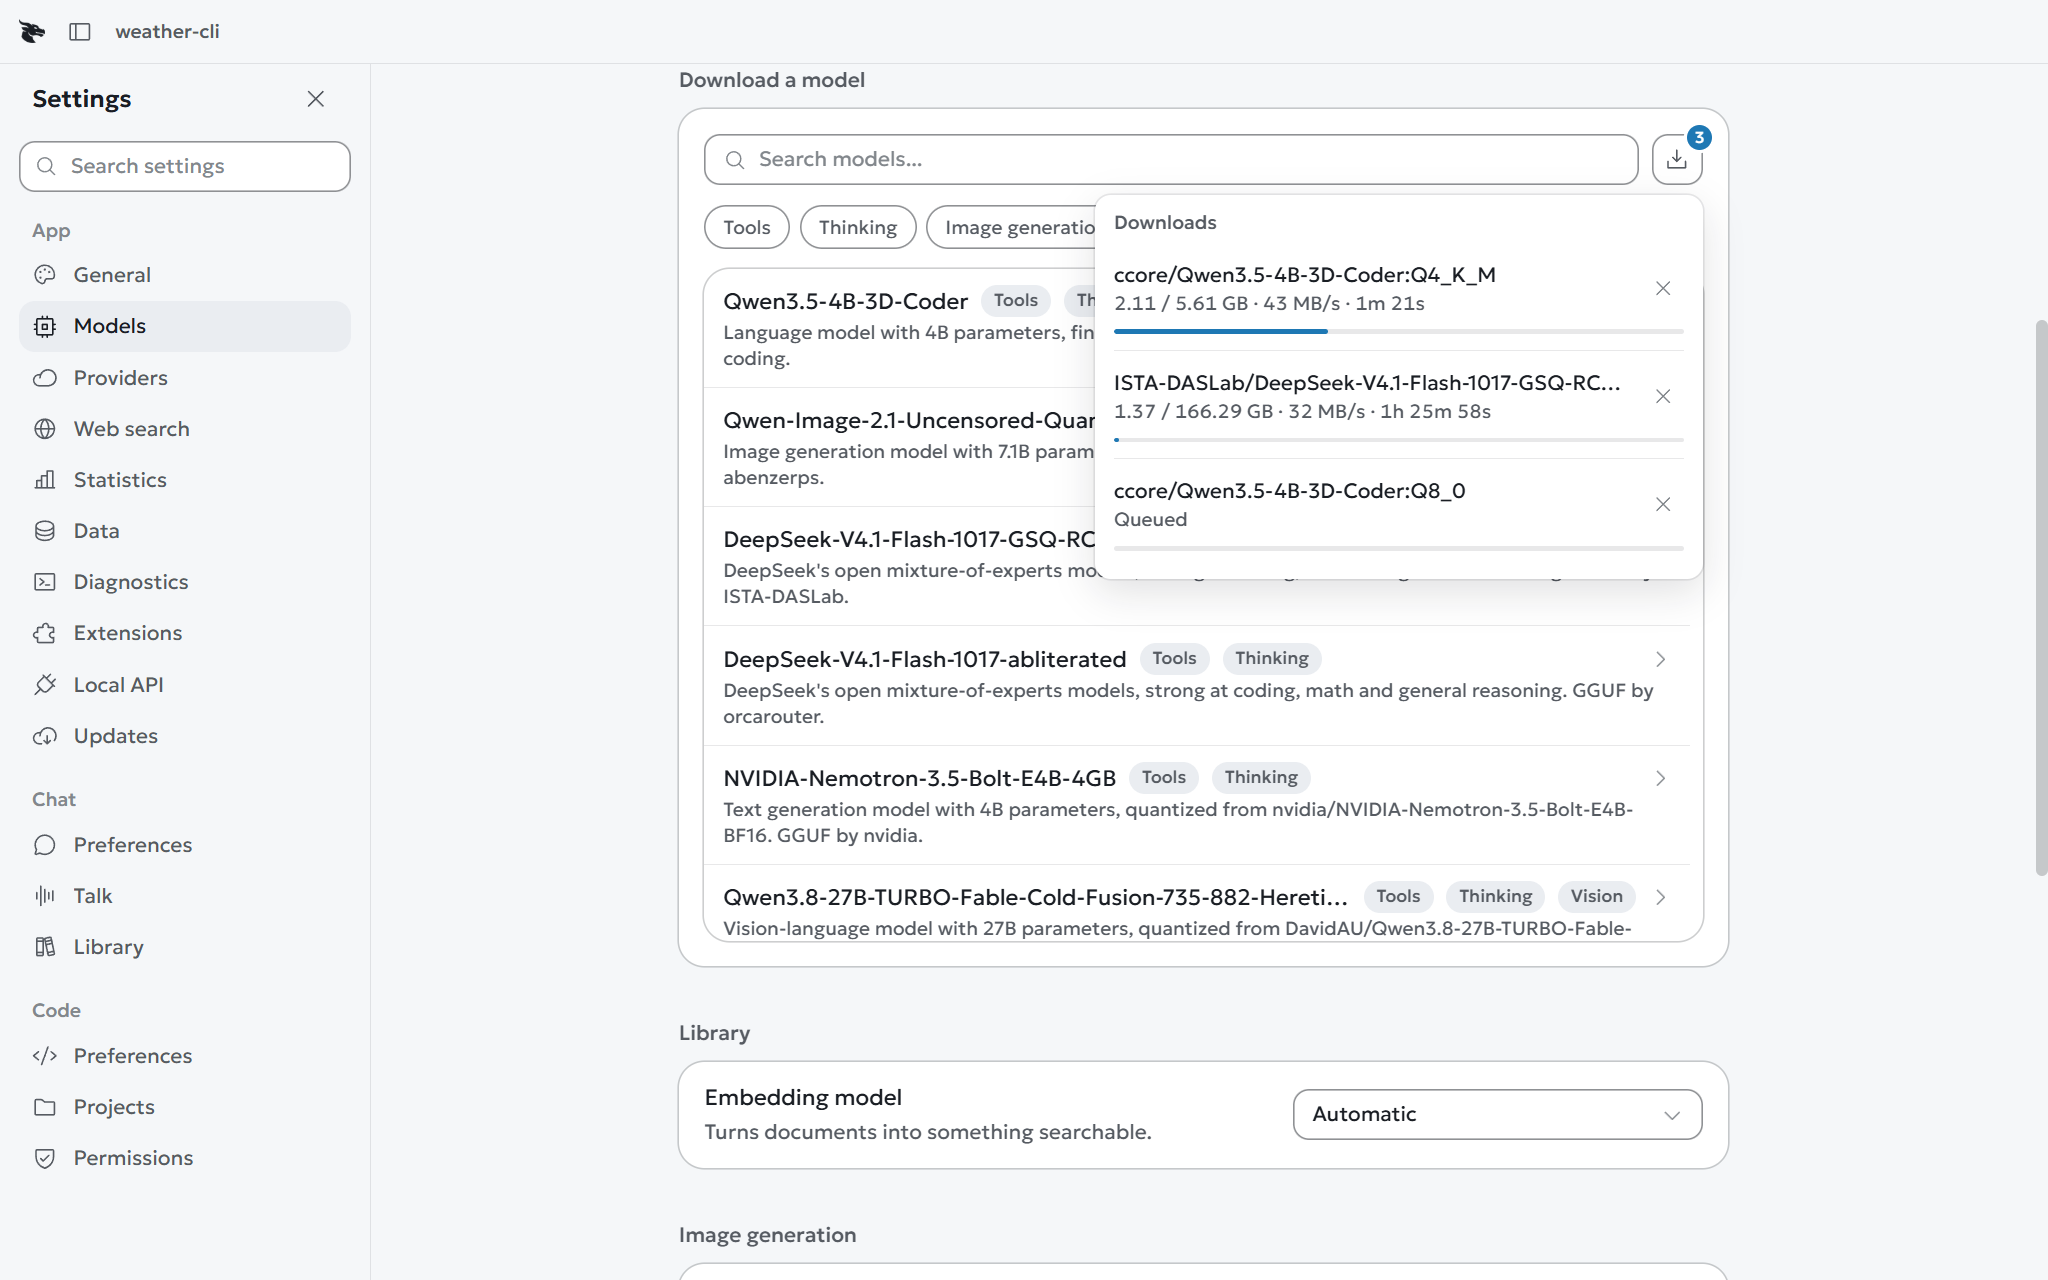
设置 → 模型 列出 Hugging Face 上最热门的 100 个 GGUF 模型,并支持搜索。点击某个模型可展开其量化版本。每个版本都会显示文件大小。
点击某个版本的下载按钮。同一时间进行两个下载,其余的在队列中等待,所以你可以排上任意多个。搜索栏右侧的下载图标会用红色角标显示有多少个正在进行。点击它可以查看每一个的进度、剩余时间和取消按钮。取消正在进行的下载会立即删除未完成的 .download 文件,取消排队中的下载则只是把它从队列中移除。
每个已安装的模型都带有标签:Chat、Code、Embedding 或 Images。嵌入模型和图像模型不会作为聊天模型提供。应用暂时无法运行的模型,例如语音识别或文字转语音,不会出现在下载列表中。
载入内存#
Draggy 仅在发送提示词时载入模型。当引擎启动时,状态行会显示实际加载进度:将模型复制到内存或显存、从磁盘读取模型、读取提示词并就绪引擎。
Windows 与 Linux#
Draggy 会选择能装下的最高档位。稠密模型必须装进显存,且不超过系统内存的 80%,因为引擎要先把整个模型读入内存。显存不足 2 GB 的机器,例如使用集成显卡的,则按系统内存的一半来算,最多计为 8 GB。
| 显存 | 稠密模型 |
|---|---|
| 1 GB 起 | Qwen 3.5 0.8B |
| 2 GB 起 | Qwen 3.5 2B |
| 3.5 GB 起 | Qwen 3.5 4B |
| 6 GB 起 | Gemma 4 E4B |
| 7.5 GB 起 | Qwen 3.5 9B |
| 9.5 GB 起 | Gemma 4 12B |
| 11 GB 起 | Ministral 3 14B |
| 15.5 GB 起 | Qwen 3.8 27B, Q3 |
| 20 GB 起 | Qwen 3.8 27B |
| 23 GB 起 | Qwen 3.8 27B, Q5 |
| 32 GB 起 | Qwen 3.8 27B, Q8 |
混合专家(MoE)模型会把活跃部分留在显卡上,其余放在内存里,所以它同时计算显存和内存:前者的 90% 加上后者的 80%,必须能装下模型文件。
| 所需内存 | MoE 模型 |
|---|---|
| 14 GB | GPT-OSS 20B |
| 19 GB | Gemma 4 26B |
| 25 GB | Qwen 3.6 35B |
| 40 GB | Qwen 3.6 35B, Q8 |
| 61 GB | Qwen 3.5 122B, Q3 |
| 82 GB | Qwen 3.5 122B |
| 94 GB | Qwen 3.8 Flash-Next, Q3 |
| 116 GB | Qwen 3.8 Flash-Next |
| 135 GB | DeepSeek V4 Flash, Q3 |
| 162 GB | DeepSeek V4 Flash |
| 210 GB | GLM-5.3-Flash |
| 250 GB | GLM-5.3-Flash, Q5 |
规模更大的模型还需要 8 GB 或以上的显卡(DeepSeek V4 Flash 需 10 GB,GLM-5.3-Flash 需 12 GB)。
Apple silicon#
Mac 没有单独的显存,所以 Draggy 只使用统一内存的 75%,把其余留给系统。基础版或 Pro 芯片用第一列的模型。内存带宽大得多的 Max 或 Ultra,在其全部内存都能装下时,用再大一档的模型。
| 统一内存 | 基础版或 Pro | Max 或 Ultra |
|---|---|---|
| 8 GB 起 | Gemma 4 E4B | Qwen 3.5 9B |
| 16 GB 起 | Ministral 3 14B | GPT-OSS 20B |
| 24 GB 起 | Qwen 3.8 27B, Q3 | Qwen 3.8 27B, Q3 |
| 32 GB 起 | Qwen 3.8 27B, Q5 | Qwen 3.8 27B, Q5 |
| 48 GB 起 | Qwen 3.8 27B, Q8 | Qwen 3.8 27B, Q8 |
| 96 GB 起 | Qwen 3.8 27B, Q8 | Qwen 3.8 Flash-Next, Q3 |
| 128 GB 起 | Qwen 3.8 Flash-Next, Q3 | Qwen 3.8 Flash-Next |
| 192 GB 起 | DeepSeek V4 Flash, Q3 | DeepSeek V4 Flash |
Intel 处理器的 Mac 不属于 Apple silicon。Draggy 会按上面「Windows 与 Linux」一节的规则来确定模型大小。
读懂 GPU 百分比#
设置 → 模型以百分比显示每个模型有多少装得进 GPU。绿色表示 98% 或以上的模型装得下。 琥珀色(60% 到 98%)表示有一部分在 CPU 上运行,速度较慢。红色(低于 60%)表示模型大了一档:请降一档。
已加载的模型在那里会多出一个卸载模型按钮,它只释放显存,不删除任何东西。
语音模型#
语音对话用的是它自己的模型,在 设置 → Chat → 语音对话里设置。