Выбор модели
Какая модель подходит к вашей видеокарте.
В список входят также модели эмбеддингов. Они превращают текст в векторы для Library и не могут вести диалог.
Просмотр и загрузка#
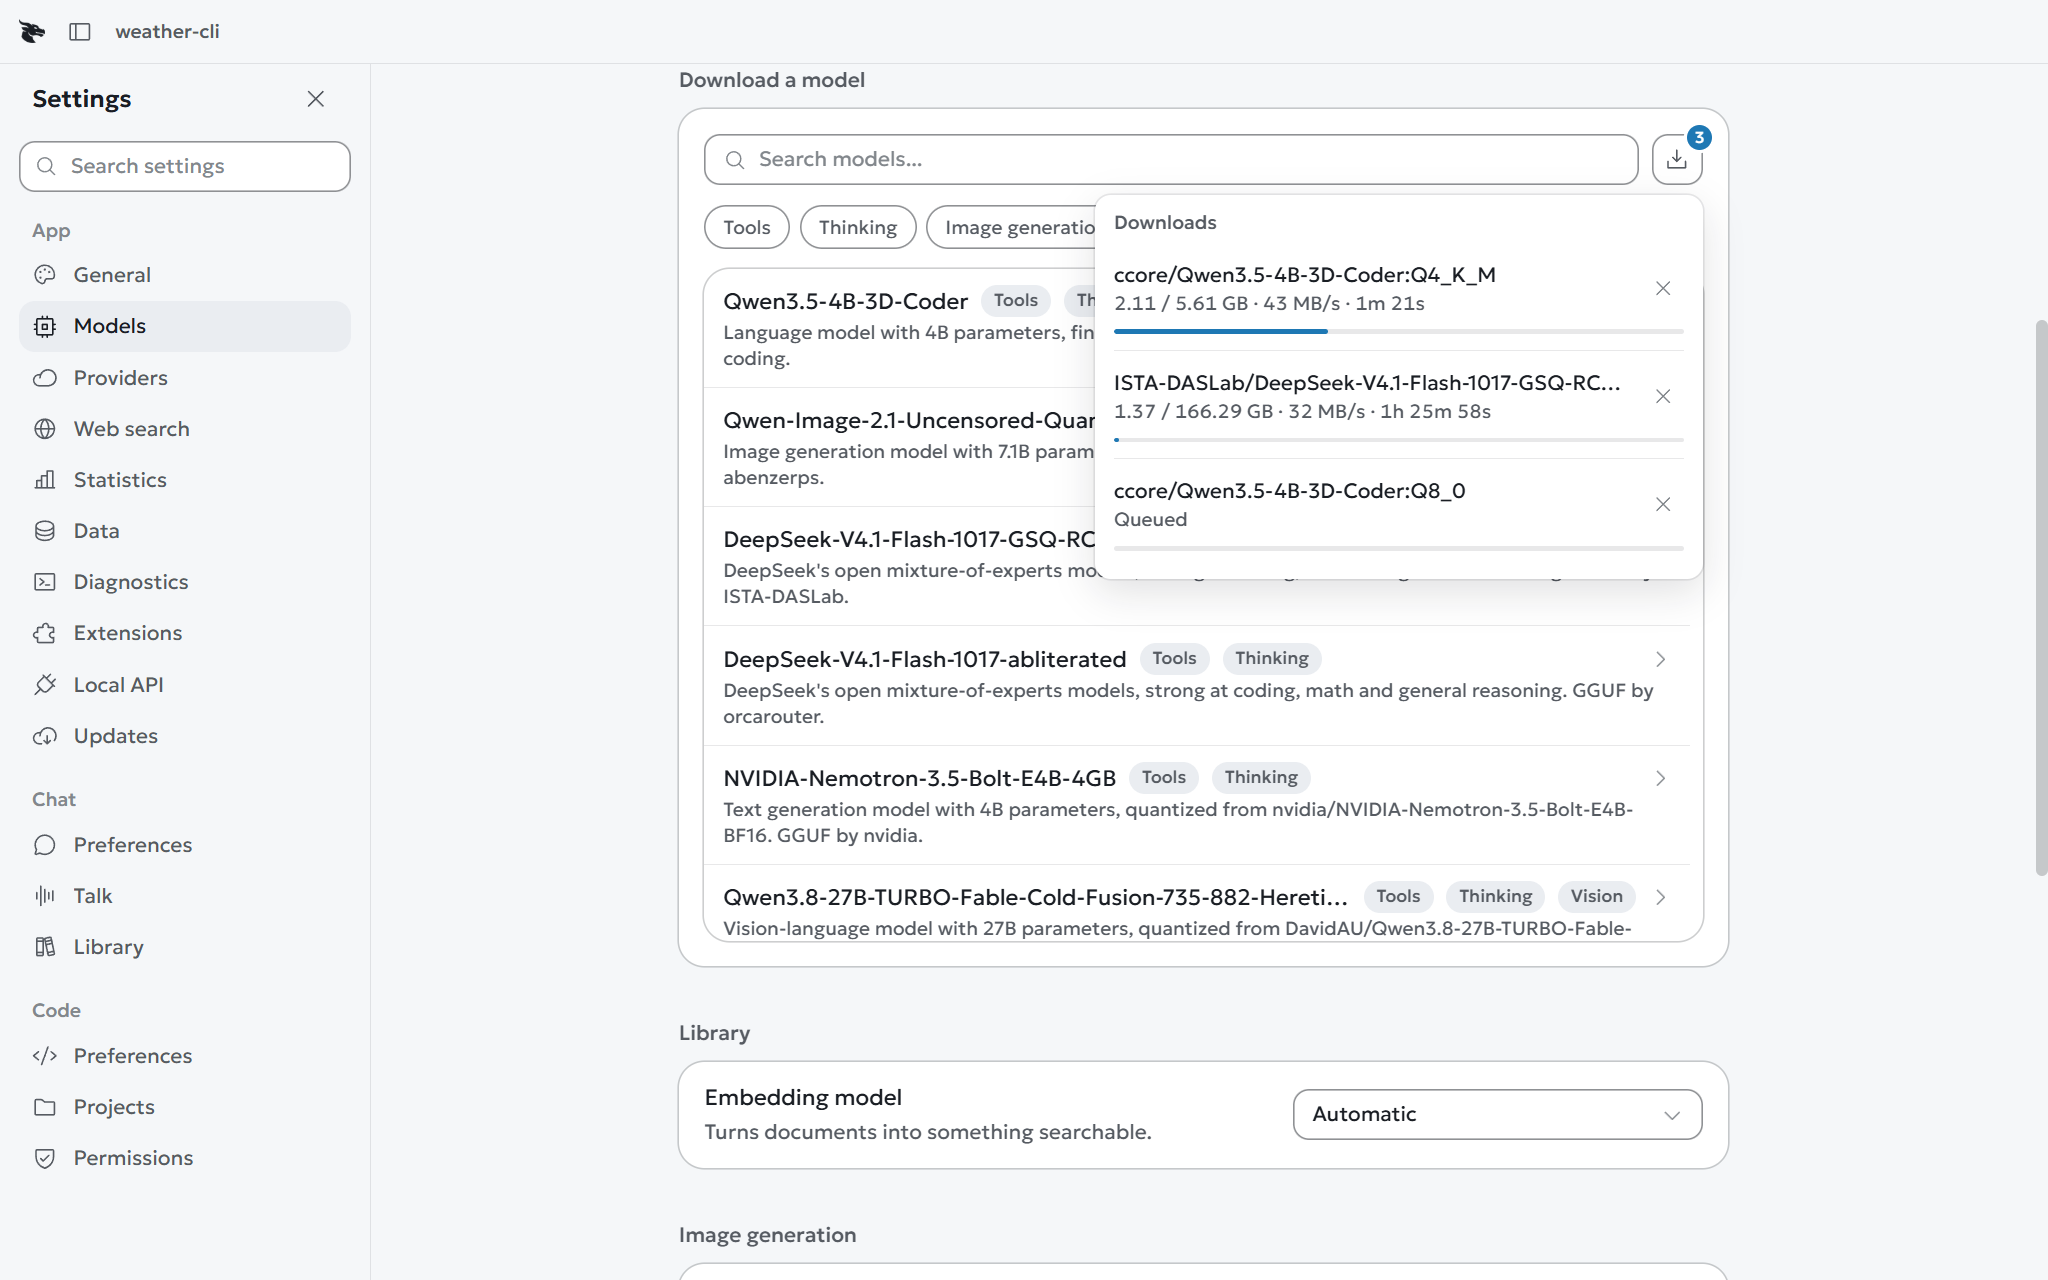
Settings → Models показывает 100 самых популярных моделей GGUF на Hugging Face, с поиском. Нажмите на модель, чтобы раскрыть её варианты квантования. У каждого варианта указан размер файла.
Нажмите кнопку загрузки у нужного варианта. Одновременно идут две загрузки, остальные ждут в очереди, поэтому можно поставить в очередь сколько угодно моделей. Значок загрузки справа от строки поиска показывает в красном бейдже, сколько загрузок ещё в пути. Нажмите на него, чтобы увидеть каждую загрузку с прогрессом, оставшимся временем и кнопкой отмены. Отмена активной загрузки сразу удаляет неполный файл .download, а отмена ожидающей загрузки просто убирает её из очереди.
У каждой установленной модели есть теги: Chat, Code, Embedding или Images. Модели эмбеддингов и модели для изображений никогда не предлагаются как модель для чата. Модели, которые приложение пока не умеет запускать, например распознавание речи или синтез речи, скрыты из списка загрузки.
Загрузка в память#
Draggy загружает модель, только когда вы отправляете запрос. Пока движок запускается, строка состояния показывает ход загрузки: копирование модели в RAM или видеопамять, чтение модели с диска, чтение запроса и подготовку движка.
Windows и Linux#
Draggy выбирает самую крупную модель, которая подходит. Плотная модель должна целиком помещаться в видеопамять и никогда не занимать больше 80% системной памяти, потому что движок сначала читает всю модель в RAM. Машина с меньше чем 2 ГБ видеопамяти, например с встроенной графикой, считается имеющей половину системной памяти, но не больше 8 ГБ.
| Видеопамять | Плотная модель |
|---|---|
| От 1 ГБ | Qwen 3.5 0.8B |
| От 2 ГБ | Qwen 3.5 2B |
| От 3,5 ГБ | Qwen 3.5 4B |
| От 6 ГБ | Gemma 4 E4B |
| От 7,5 ГБ | Qwen 3.5 9B |
| От 9,5 ГБ | Gemma 4 12B |
| От 11 ГБ | Ministral 3 14B |
| От 15,5 ГБ | Qwen 3.8 27B, Q3 |
| От 20 ГБ | Qwen 3.8 27B |
| От 23 ГБ | Qwen 3.8 27B, Q5 |
| От 32 ГБ | Qwen 3.8 27B, Q8 |
Модель со смесью экспертов (MoE) держит активную часть на видеокарте, а остальное в RAM, поэтому считаются видеопамять и RAM вместе: 90% первой плюс 80% второй должны вмещать файл.
| Нужная память | Модель MoE |
|---|---|
| 14 ГБ | GPT-OSS 20B |
| 19 ГБ | Gemma 4 26B |
| 25 ГБ | Qwen 3.6 35B |
| 40 ГБ | Qwen 3.6 35B, Q8 |
| 61 ГБ | Qwen 3.5 122B, Q3 |
| 82 ГБ | Qwen 3.5 122B |
| 94 ГБ | Qwen 3.8 Flash-Next, Q3 |
| 116 ГБ | Qwen 3.8 Flash-Next |
| 135 ГБ | DeepSeek V4 Flash, Q3 |
| 162 ГБ | DeepSeek V4 Flash |
| 210 ГБ | GLM-5.3-Flash |
| 250 ГБ | GLM-5.3-Flash, Q5 |
Самым крупным моделям также нужна видеокарта от 8 ГБ и больше (10 ГБ для DeepSeek V4 Flash и 12 ГБ для GLM-5.3-Flash).
Apple silicon#
У Mac нет отдельной видеопамяти, поэтому Draggy использует 75% унифицированной памяти и оставляет остальное системе. Чипы Base и Pro берут модель из первого столбца. Чипы Max и Ultra, у которых заметно выше пропускная способность памяти, берут модель на размер больше, если вся их память может её вместить.
| Унифицированная память | Base или Pro | Max или Ultra |
|---|---|---|
| От 8 ГБ | Gemma 4 E4B | Qwen 3.5 9B |
| От 16 ГБ | Ministral 3 14B | GPT-OSS 20B |
| От 24 ГБ | Qwen 3.8 27B, Q3 | Qwen 3.8 27B, Q3 |
| От 32 ГБ | Qwen 3.8 27B, Q5 | Qwen 3.8 27B, Q5 |
| От 48 ГБ | Qwen 3.8 27B, Q8 | Qwen 3.8 27B, Q8 |
| От 96 ГБ | Qwen 3.8 27B, Q8 | Qwen 3.8 Flash-Next, Q3 |
| От 128 ГБ | Qwen 3.8 Flash-Next, Q3 | Qwen 3.8 Flash-Next |
| От 192 ГБ | DeepSeek V4 Flash, Q3 | DeepSeek V4 Flash |
Mac с процессором Intel не относится к Apple silicon. Draggy подбирает для него модели по правилам из раздела «Windows и Linux» выше.
Как читать показатель GPU#
Settings → Models показывает, какая доля каждой модели помещается на GPU, в процентах. Зелёный означает, что помещается 98% модели или больше. Янтарный, от 60% до 98%, работает с частью модели на CPU, что медленнее. Красный, меньше 60%, означает, что модель слишком велика: выберите размер меньше.
У загруженной модели здесь появляется кнопка Unload, которая освобождает видеопамять, ничего не удаляя.
Модель talk#
Голосовой режим использует собственную модель, которую задают в Settings → Chat → Talk.